Wat de tool capteert
Dit is het eenvoudigste mechanisme. Deze data komt tot stand omdat het bedrijf of de persoon de data zelf invult. Zo zijn er tal van voorbeelden over verschillende tools heen.
Laten we starten met LinkedIn. Gebruik je Sales Navigator of LinkedIn Campaign Manager, dan heb je ongetwijfeld al selecties gemaakt waarbij je segmenteert op basis van een aantal persoons- en/of bedrijfscriteria.
- Werknemersaantal is daar een duidelijk voorbeeld. Afhankelijk van hoe je die filter opstelt, krijg je verschillende resultaten. Zoek je op range (bijv. 11 – 50 FTE), dan weet je dat dit informatie is die het bedrijf zelf heeft opgegeven. Je kiest die ranges namelijk bij het aanmaken van je LinkedIn company page.
- En er zijn nog meer cases te maken voor LinkedIn. Zo wordt de senioriteitsfilter gebaseerd op een interpretatie van de functietitel die een persoon zelf aangeeft. Zoek je bijvoorbeeld op “owners” binnen HR-bedrijven, dan kan het goed zijn dat je daar de nodige freelancers mee in je resultaten krijgt. Een dure marketingcampagne wordt dat dan.
Dit is overigens niet enkel een “issue” bij LinkedIn. Maak je in databases die op KBO gebaseerd zijn (zoals Trendstop) selecties op basis van NACE-codes, dan is ook daar een marge om rekening mee te houden. Een onderneming legt die activiteiten vast bij de oprichting, en in het typisch Belgische ondernemersland vinkt men er liefst zoveel mogelijk aan, voor het geval dat. Filter je op NACE-code, dan krijg je dus ook bedrijven die die activiteit nooit structureel uitgeoefend hebben.
Wat dit zegt over de tool
Dit betekent niet dat de tool foute informatie weergeeft. Hij is louter afhankelijk van wat een bedrijf of persoon zelf heeft aangegeven, en iemand geeft natuurlijk aan hoe hij/zij zichzelf wil tonen. Dat is een vorm van informatie, maar daarom geen feitelijkheid.
De afstand met de werkelijkheid groeit hier doorgaans ook naarmate de tijd vordert. Vaak is er geen sense of urgency om deze informatie te wijzigen, dus na enkele jaren ligt dit vaak ver van de werkelijkheid.
Wat de tool capteert
De volgende stap is het linken van data door het platform zelf. In de meeste gevallen doen ze dat goed, maar soms gaat het ook spectaculair mis.
Zelfde LinkedIn-voorbeeld op basis van het aantal medewerkers. Zoek je via Sales Navigator, dan kan het goed zijn dat er onder diezelfde werknemersfilter (11 – 50 fte) bedrijven tevoorschijn komen die zogezegd 300+ medewerkers hebben. LinkedIn koppelt mensen aan het bedrijf op basis van een naammatching wanneer zij zelf niet aan een officiële LinkedIn-bedrijfspagina hangen. Iedereen zal ongetwijfeld al gemerkt hebben dat ze volgens LinkedIn collega’s hebben op een ander continent die nog nooit het kantoor binnenwandelden.
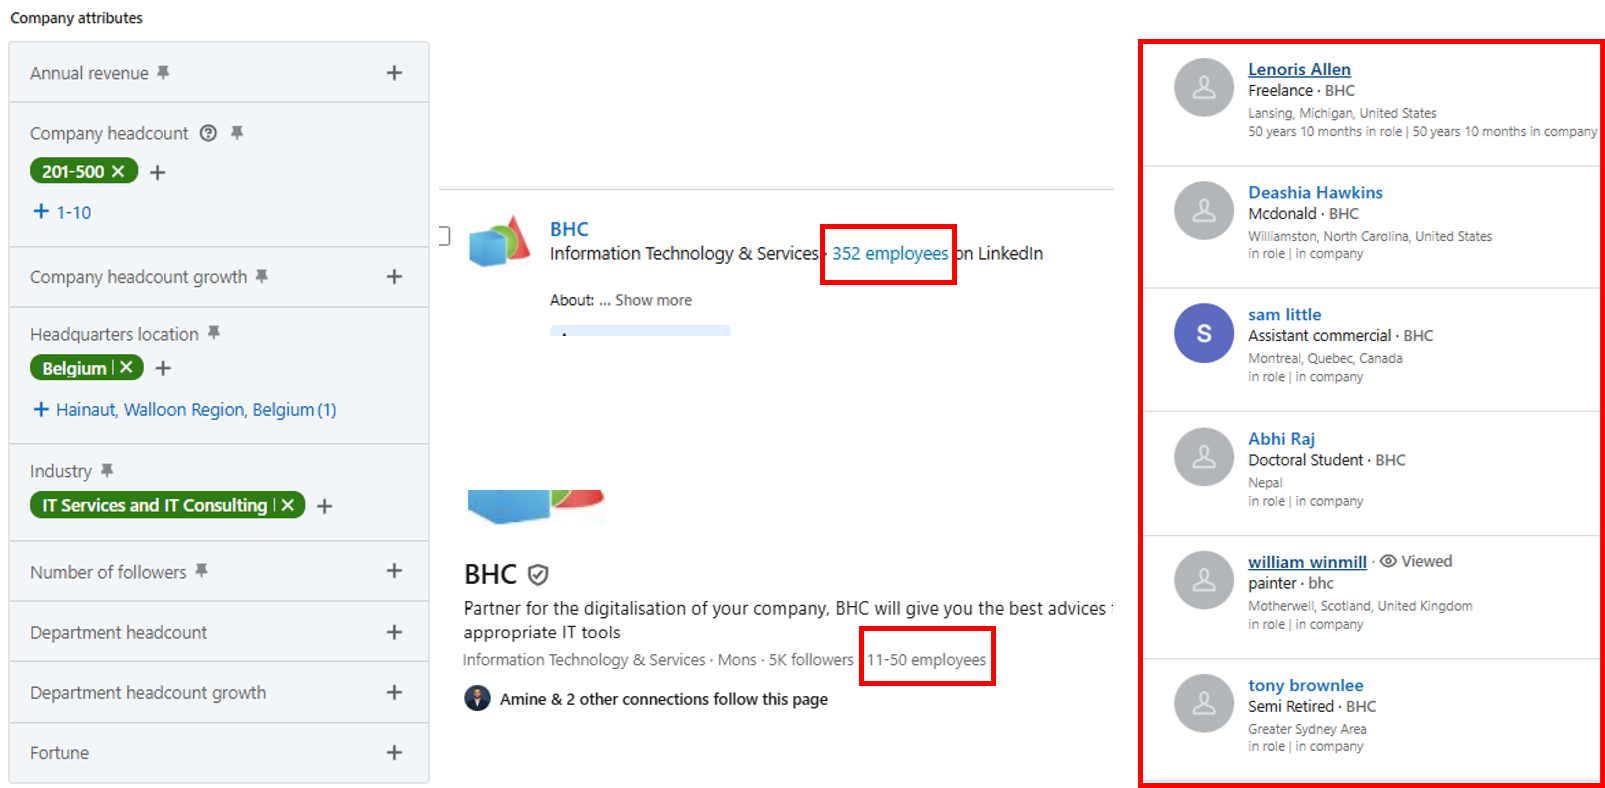
Bij tools van eigen bodem doet deze problematiek zich voor wanneer er koppelingen worden gelegd tussen een bedrijvengroep en de legale entiteiten. Op zich is het heel nuttig dat de tool dit doet, want een groep met 10 vennootschappen is voor sales vaak 1 “commercieel account” en moeder-dochter relaties worden op die manier duidelijk. Een ander mechanisme is echter dat men entiteiten kunstmatig bundelt omdat die toevallig één LinkedIn bedrijfspagina delen. Afhankelijk van de filter die je gebruikt zijn de resultaten heel anders.
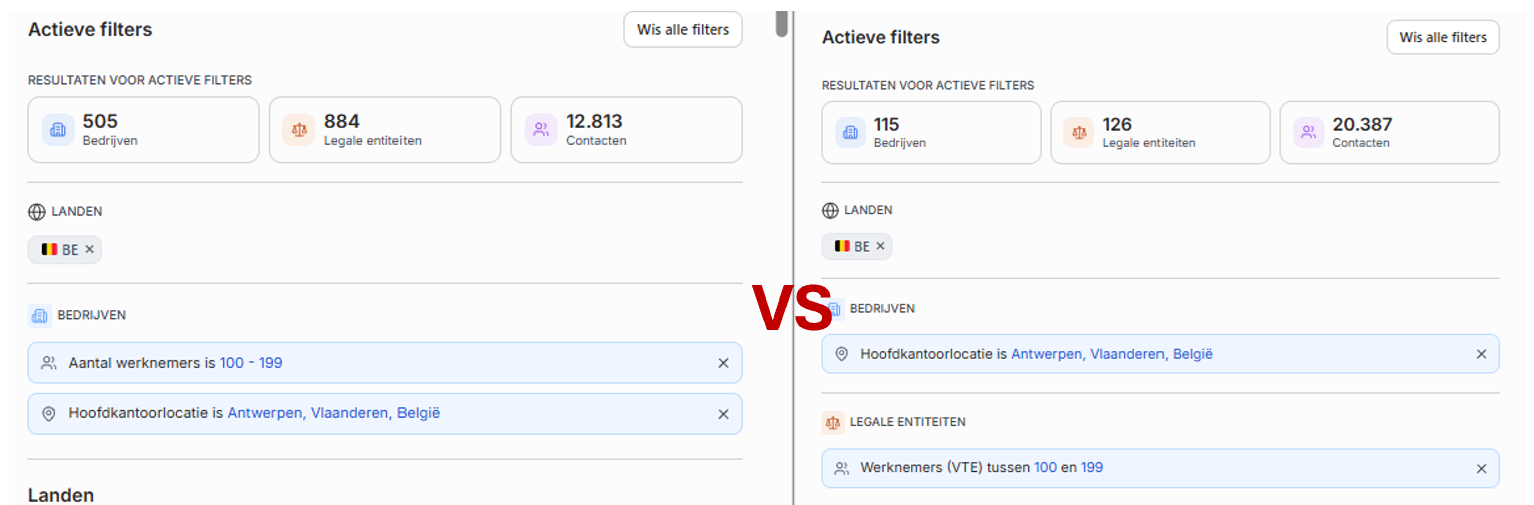
Wat dit zegt over de tool
Een gekoppeld veld hangt samen met de kwaliteit van de koppeling en dat blijkt geen evidentie. Klopt de match, dan klopt het getal. Klopt ze niet, dan tel je naamgenoten, dochterbedrijven of “collega’s” die er nooit gewerkt hebben.
Wat de tool capteert
Hier wordt het interessant. Steeds meer velden zijn het resultaat van een model dat ruwe data interpreteert. Dat is snel en schaalbaar, maar voor de gebruiker vaak een black box.
Sommige tools zijn hier transparant over. Denk aan de tool Sumble. Volgens hun eigen documentatie vertrekt hun organisatiedata vanuit twee primaire bronnen: vacatures en persoonsprofielen. Daaruit leiden ze onder meer headcount, industrie en techstack af, en technologieën worden met ML-modellen uit vacatureteksten gehaald.
Andere tools zijn net iets minder transparant. Zo spreekt Lusha over meer dan 25.000 technologieën, geclassificeerd met een eigen model voor zowel front-end technologie als technologie “achter de firewall”. Front-end technologie kan je afleiden uit de code van een website. Een ERP of een intern CRM zie je daar niet. Hoe Lusha die tweede categorie bepaalt, staat niet in hun documentatie.
Opnieuw een voorbeeld waar dit mis kan lopen. Bepaalde tools laten toe te filteren op de parameter “activiteiten”. Dit is een logische picklist die ze zelf hebben samengesteld (dus niet de NACE-codes of LinkedIn Sectoren). Deze activiteiten worden bepaald door de websites van bedrijven te scrapen en de inhoud daarna door een LLM te laten interpreteren. Maar ook hier is er natuurlijk een foutenmarge. Zo belandde een bedrijf in netwerkoplossingen onder de categorie “goederenvervoer”, omdat er ergens op de website melding wordt gemaakt van “goederenvervoer”, maar dat “ergens” kan dus ook de reference case zijn van een klant die actief is in die sector.
Wat dit zegt over de tool
Gebruik je afgeleide data, dan hangt de kwaliteit af van hoe zichtbaar een bedrijf online is. Een model kan namelijk enkel interpreteren wat het vindt. Dus, hoe meer input er over een bedrijf te vinden en te scrapen valt, hoe correcter het profiel.
Daarom werken dit soort velden bij grote multinationals en Amerikaanse bedrijven vaak een stuk beter dan bij een kleine Belgische kmo. Geen vacature of geen tag op de website betekent echter nog niet dat een technologie er niet gebruikt wordt en omgekeerd, soms worden zaken die op de website van het Amerikaanse moederbedrijf worden teruggevonden, verkeerd geattribueerd aan de Belgische entiteit.
Wat de tool capteert
Veel tools kopen data in bij een handvol grote leveranciers. Wie wil weten waar een veld echt vandaan komt, moet dus soms een laag dieper kijken dan de tool die op zijn scherm staat.
Dat model is ouder dan je zou denken. Dun & Bradstreet begon al in 1841 met kredietinformatie over bedrijven en introduceerde in 1963 het D-U-N-S-nummer, een unieke identificatie per bedrijf om organisaties over systemen en landsgrenzen heen te koppelen. Bedrijfsdata is dus oorspronkelijk ontstaan vanuit risico en kredietwaardigheid, op niveau van de entiteit. Veel klassieke bedrijfsdatabanken dragen dat DNA nog altijd mee.
Daarna kwam een generatie leveranciers die vooral op het web bouwde. Clearbit verrijkte bedrijfsrecords met meer dan 100 datapunten uit onder meer sociale profielen, bedrijfswebsites en crowdsourcing. Sindsdien is de markt van spelers die data louter verkopen als grondstof ook enorm gegroeid. Een nieuwe tool met een strak design kan dus perfect draaien op de database van iemand anders.
Intent is het duidelijkste voorbeeld van ingekochte data. De intentscores van Lusha zijn gebaseerd op Bombora, dat onderzoeksgedrag volgt via een coöperatief netwerk van meer dan 5.000 B2B-websites. Ook Prospeo vermeldt intentdata over 15.000 Bombora-topics. Twee tools, één onderliggende bron. Wie beide naast elkaar gebruikt in de veronderstelling twee onafhankelijke signalen te hebben, kijkt eigenlijk twee keer naar hetzelfde.
Wat dit zegt over de tool
Een ingekocht veld meet wat iemand anders zag. Je erft de sterktes en de blinde vlekken van de oorspronkelijke verzamelaar, en de tool waarin je werkt vertelt je zelden wie dat was.
Een foutenmarge zal er altijd zijn. Welke foutenmarge aanvaardbaar is, hangt af van het doel. Denk aan marketing die een campagne opzet, een business developer die een prospectielijst bouwt, een accountmanager die één prospect analyseert, management die een CRM-koppeling instelt. Elk vertrekt van een ander doel, en dus van een andere tolerantie.
Daarom moet iedereen die met deze tools werkt zichzelf dezelfde vier vragen stellen, telkens in functie van het eigen doel:
- Hoe kwam de data tot stand? Zelf ingevuld, via een koppeling, via een scrapingmodel of via een andere partij?
- Op welk niveau? Gaat het over de groep, over de legale entiteit, of over een kunstmatige bundeling van entiteiten die toevallig één LinkedIn bedrijfspagina delen?
- Hoe zichtbaar is dit bedrijf online? Hoe kleiner en lokaler, hoe minder je op afgeleide velden mag leunen.
- Hoe groot zijn de discrepanties? Leg de data uit verschillende bronnen naast elkaar en kijk naar de verschillen. Zie je grote gaps, dan doe je best nog eens een manual check.
Op basis van het antwoord op deze vragen kan je de foutenmarge inschatten. En de aanvaardbaarheid daarvan hangt af van het doel. Wat voor een campagne volstaat, is voor een CRM-koppeling en persoonlijke outreach misschien te riskant. Denk aan prospectieboodschappen van business developers naar IT-managers vanuit de tool waarmee het bedrijf in kwestie werkt. Dan is er een nultolerantie op fouten.
De gouden regel is dus je team pas te laten vertrouwen op een tool als het kan uitleggen waar een veld vandaan komt en de foutenmarge kan verantwoorden.
Twijfel je of je toolset en je data je prospectie echt ondersteunen? Met onze Sales & Marketing Automation services kijken we graag mee welke bronnen je gebruikt en hoe je er scherper mee filtert.